
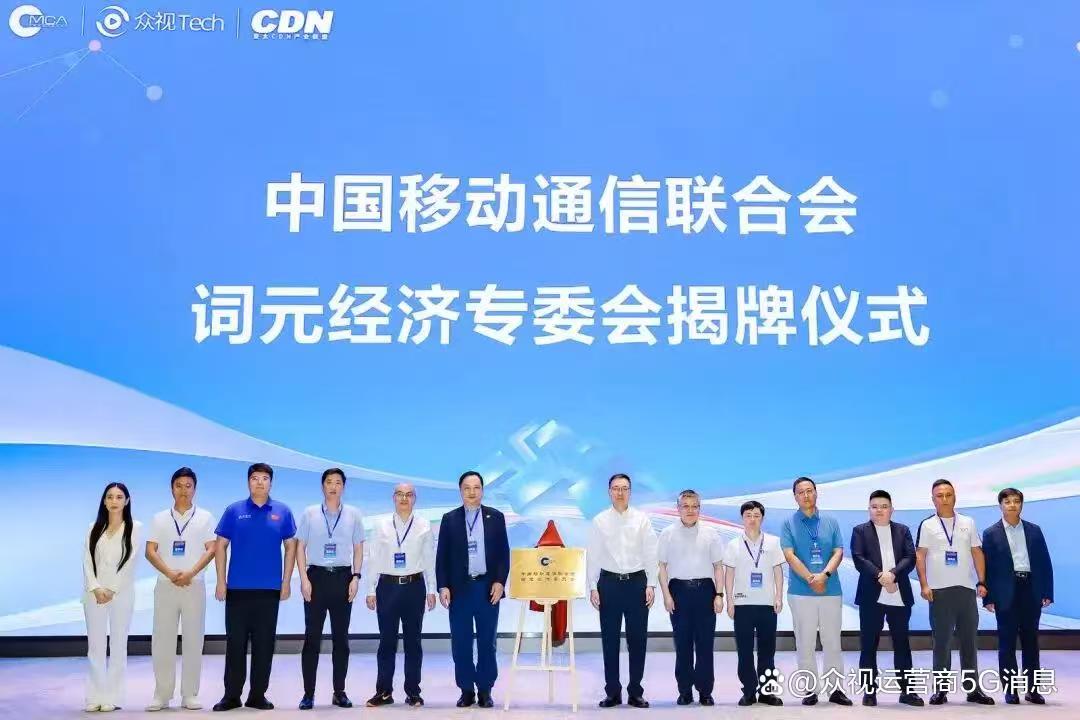
 《北京市加快词元经济发展的行动方案(2026—2028年)》由北京市经信局、市发改委于2026年9月15日印发、18日对外发布,是全国首个省级“词元经济”专项政策,有效期至2028年底。它的核心不是再补贴几个大模型,而是把 Token/词元从“模型内部计数单位”升级为“智能经济可计量、可评测、可定价、可流通”的产业要素,按“生产—评测分发—消费—行业知识—出海—要素保障”全链条建制度。下面按深层逻辑拆开讲。
一、先厘清:词元经济到底在管什么?
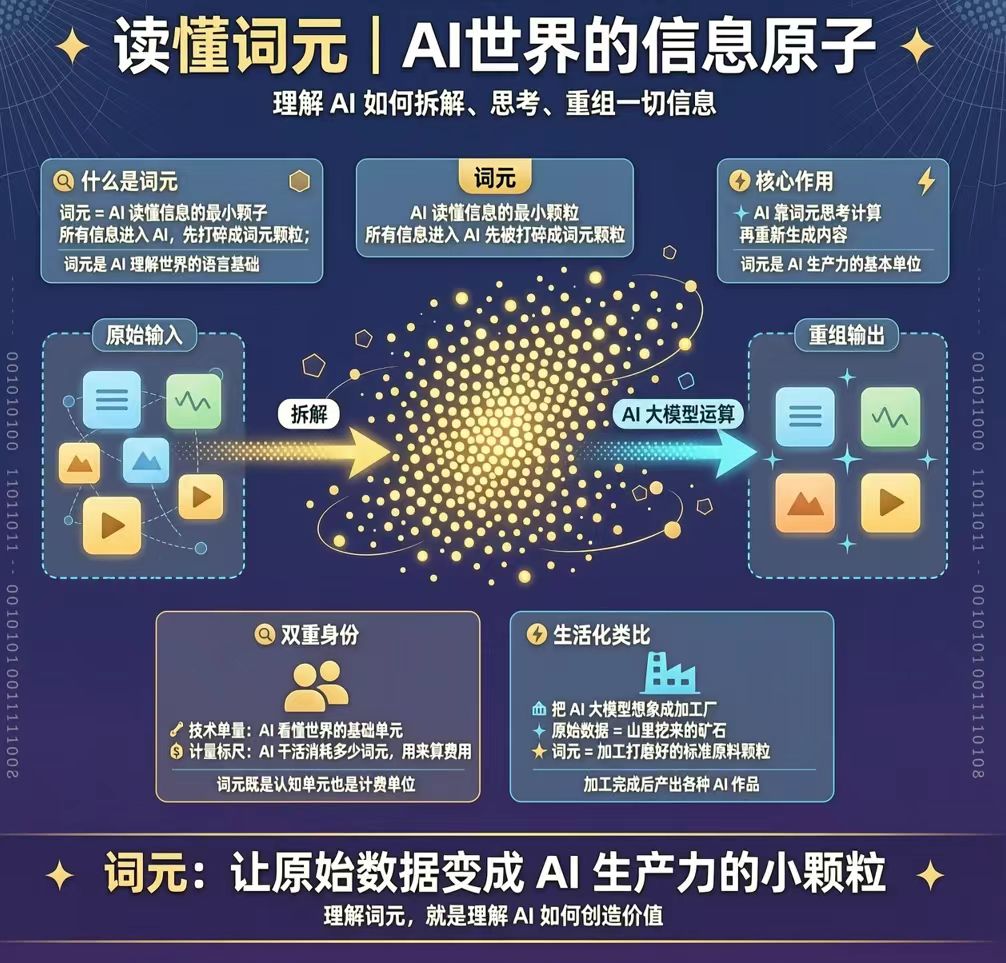
词元(Token)是大模型切分文本、代码、图像、音视频后的最基础计算单元;一次问答、一次智能体任务,最终都折算成输入/输出词元消耗。 北京把它当成“智能经济的水电煤表”:
计量维度:按词元数计算力工作量、算服务成本、做结算;
质量维度:同样100万词元,低质模型可能空转、重复、幻觉,高质模型能完成一个任务,价值密度完全不同;
流通维度:需要评测、路由、分发、计价、结算,类似CDN/云计算的资源市场,但标的是“模型推理产出”而非裸算力。
官方背景数据很关键:国家数据局口径下,国内日均词元调用从2024年初约1000亿,到2025年底约100万亿,2026年5月突破500万亿;北京已投用“北京壹号词元工厂”“京算词元工厂”,壹号一期日产能超1.4万亿词元。量已经爆炸,但“怎么算好词元、怎么定价、怎么避免空转”没规则——这份方案就是补规则。
注意边界:词元是“资源消耗/服务工作量”的结算单位,不是代币、不是可炒虚拟货币;政策明确政府不做统一定价,市场定价为主,政府做标准、评测、基础设施。
二、方案骨架:六大方向、十条(“词元十条”)
按官方宣贯和全文,可归成六块:
1.生产端·词元工厂
制定北京词元工厂分级评价标准,指标含模型适配数量、词元吞吐速度、首字延迟、缓存命中率、PUE(电能效率);
攻关基础模型、提升“模型智能上限”;推动模型—芯片适配,支持推理专用芯片、模型轻量化、边缘部署;
高水平建智算中心、统筹智算资源,打造“世界级词元工厂”。
2.流通端·评测+分发
建词元质量评测体系、探索词元测试平台;用模型智能路由、评测咨询形成可持续运营;
建词元分发平台:统一接口、模型聚合、跨模型/跨模态/跨区域、词元计量与结算,纳入新型基础设施。
3.消费端·智能体生态
通用智能体(个人/企业)+垂直智能体(工业、科研、生物医药、教育等);
智能体核心软件生态、“智能体驾驭提升工程”;信息咨询、商业、生活服务先规模化。
4.行业知识·新型工业化
探索数据本体技术范式,把行业知识、工艺参数、设备数据封装成数据产品; 推动AI赋能工业制造,形成可调用、可计词的行业知识服务体系。
5.开放端·出海
建中国—上合组织国家AI应用合作中心,向“一带一路”/新兴市场输出开源模型适配、智能体部署、工具链、算力一体方案;培育海外开发者生态。
6.要素端·金融+人才
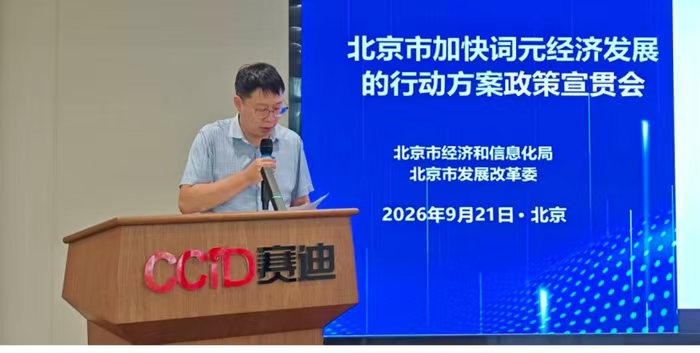
金融支持(词元工厂、分发平台、智能体企业融资/保险/结算等)、人才服务;宣贯会已有银行、评测、算力企业对接。
三、深层意图:从“拼模型参数”转向“拼有效词元产出”
这份方案有三个明显政策转向:
1)用工厂分级淘汰“低效堆算力”
过去地方建智算中心常比PFLOPS、比卡数;北京改比“每度电出多少有效词元、首字多快、缓存命中多少、模型智能上限多高”。按协会口径,北京目前1度电约产400万—500万词元,分级标准会把高PUE、低命中、低智能的产能挤出去。 这相当于把智算中心ISO化、像智能工厂一样评级。
2)用评测解决“同模型不同质量”
用户接同一个开源模型,因推理框架、缓存、量化、芯片适配不同,输出质量和成本差很大。北京首次把“词元质量评测”作为流通基础设施,未来可能形成:测试平台出分→智能路由选模型/选厂→分发平台按质计价。政府不当定价局,但当“裁判+接入规范制定者”。
3)用智能体把词元从“聊天量”变成“任务量”
单纯对话按字数烧词元;智能体做多轮检索、调工具、跑工作流,词元消耗更大,但对应“完成订单/诊断/仿真/排产”等可计价业务。方案重点列工业、医药、科研、教育,是把词元需求和北京既有优势产业绑定,而不是只养Chat应用。
四、产业影响:谁受益、谁要补功课
1.智算/词元工厂与IDC:京内已有壹号、京算项目,后续分级标准、PUE、首字延迟会成为拿项目和客户的关键;纯堆A100/H系列而无调优能力的机房劣势变大。
2.推理芯片与国产适配:方案点名推理专用芯片、轻量化、边缘端;国产卡做上下文/理解、高端卡做低延迟生成的分段混合推理会有政策空间。
3.评测与标准服务:中国软件评测中心已介入工厂分级、数据集质量、智能体效能; 第三方评测、红队测试、行业基准库会成新生意。
4.分发平台/MaaS聚合:拥有统一接口、跨模型路由、计量结算能力的平台(大厂云、运营商、独立MaaS)会被纳入新基建逻辑;小模型厂商可借分发降低获客成本。
5.垂直智能体:工业制造、生物医药、科研、教育、商业服务最先用北京场景和标杆项目;有行业数据+工作流+工具调用能力的团队优于纯提示词团队。
6.数据产品供应商:工艺参数、设备数据、行业知识封装成“可计词元调用”的产品,利好工业软件、科研数据、医学知识库厂商。
7.出海与合规:上合/一带一路AI合作中心、跨境API、来数加工、境内推理闭环、跨境资金结算,会带动合规咨询与离岸算力运营。
五、落地难点(看半年到两年)
1.评测结果能不能当定价基准:若只头部玩、评测贵,市场仍按品牌信任采购;要做低成本的持续评测、行业细分基准,否则“参考”变“摆设”。
2.国产芯片适配节奏:模型一两月一版,芯片驱动/编译/量化跟进慢;分段推理能缓解,但“先进:国产”配比、SLA保障还没细化。
3.词元空转治理:分级标准和智能上限若只看基准分,企业可刷分;需要结合业务完成率、返工率、人工接管率等“任务级指标”。
4.数据本体与产权:行业知识封装涉及工艺秘密、个人信息、跨境数据;工业/医药场景若数据不出厂、只出词元,需配套匿名化与授权机制。
5.出海资金与合规:词元API小额高频,跨境收款、税务、制裁名单、模型出口管制都要细规则;北京提“合作中心”但企业端仍缺操作指引。
六、一句话定位
这份方案本质是给“大模型推理服务”建类电力/类网络的公共市场规则:政府定工厂等级、定质量评测、建分发枢纽,市场按词元结算,智能体在行业场景消耗词元,国产算力和标准能力借此从“可用”走向“可计价、可规模输出”。对北京而言,是用Token把智算、模型、行业数据、智能体、出海五件事串成一条智能经济供应链。


