
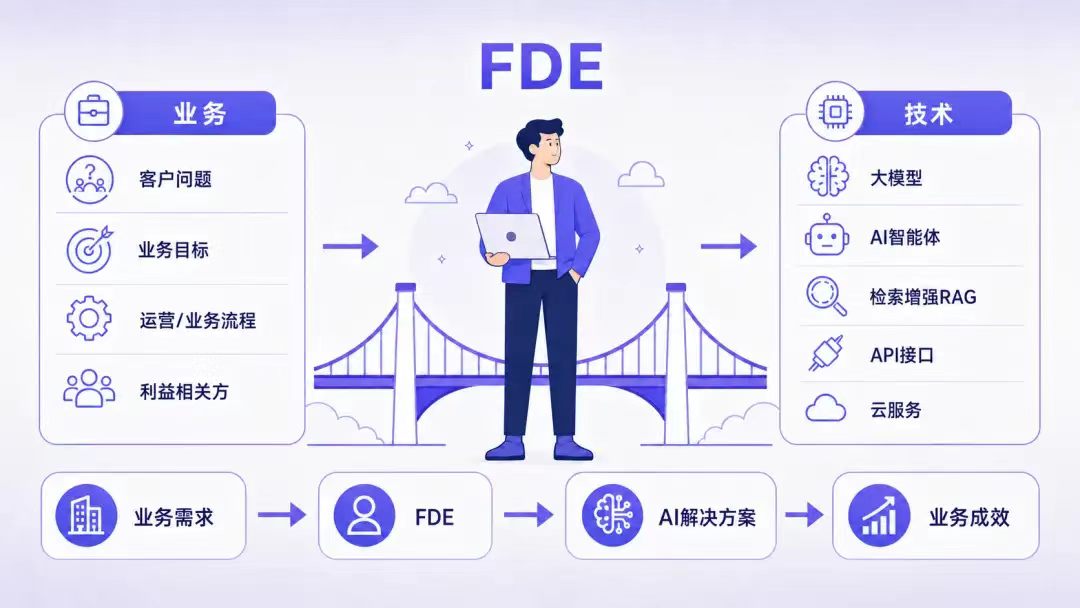
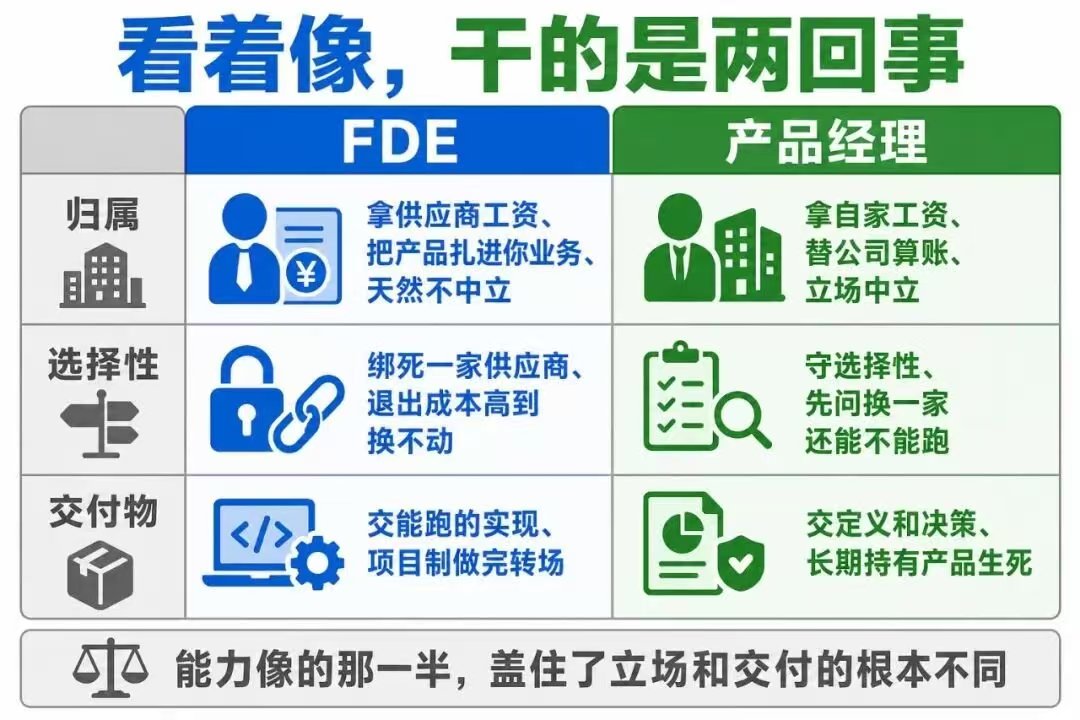
要成为真正的前沿部署工程师(FDE),核心在于“用工程化的确定性,去驯服大模型的不确定性”。这需要一条跨学科的成长路径,既要懂AI,又要懂后端,还要懂运维。结合专家们的建议梳理了一份“从0到1”的实战学习路线图,分为四个阶段,每个阶段都对应具体的技能树和实操项目:

第一阶段:夯实地基(掌握“物理法则”)
目标:理解大模型的能力边界和运行机制,掌握基础工程工具。
必学内容:
Python 高级特性:异步编程(asyncio)、类型提示、装饰器。这是写Agent的基础,因为Agent本质上是大量IO密集型操作。
API 交互与数据结构:熟练掌握 RESTful API、WebSocket、SSE(Server-Sent Events)流式输出。了解 Token 计费机制,理解为什么流式输出能优化用户体验。

基础机器学习概念:了解 Embedding(向量化)、相似度计算、上下文窗口(Context Window)、温度(Temperature)等参数对输出的影响。
数据库基础:掌握关系型(PostgreSQL)和向量数据库(如 Milvus、pgvector)的读写,这是状态持久化和RAG(检索增强生成)的基础。
实操项目:用 Python 调用大模型API,写一个支持流式输出、能保存历史记录的简单 CLI 聊天机器人。

第二阶段:核心构建(学会“搭建骨架”)
目标:掌握维度1和维度2(后面解释),学会把复杂业务拆解并让模型调用工具。
必学内容:
提示词工程(Prompt Engineering):深入理解结构化输出(JSON Mode)、Few-shot、思维链(CoT)。这是让模型“听指挥”的底层能力。
工作流与Agent框架:学习 LangChain/LangGraph 或 LlamaIndex。重点不是背API,而是理解它们的抽象概念:节点(Node)、边(Edge)、状态(State)和条件路由。
函数调用(Function Calling):深入理解如何定义工具Schema,让模型学会“看说明书用工具”。学会处理工具返回的异常和超时。
上下文工程:学习 RAG 的进阶玩法,比如:如何做查询改写、重排序(Rerank)、上下文压缩(Context Compression)和记忆管理(Memory)。
实操项目:构建一个多智能体协作系统(例如:一个负责查天气,一个负责查航班,一个负责整合信息的旅行规划Agent)。重点练习任务如何拆解、工具如何调用、失败如何重试。
第三阶段:生产化打磨(学会“穿上铠甲”)
目标:掌握维度3和维度4(后面解释),这是“前沿部署”与“普通开发”的分水岭。
必学内容:
评测体系(Evaluation):学习如何构建测试集(Golden Set),掌握 LLM-as-a-Judge(让大模型打分)和传统相似度评测(如 BLEU、Rouge)的优劣。这是你优化Prompt时唯一的“尺子”。
可观测性(Observability):学习使用 LangSmith、Langfuse 或 OpenTelemetry。核心技能是看Trace:能通过链路追踪看到“模型看到了什么上下文、为什么调用了这个工具、哪一步耗时最长”。

可靠性工程:学习Durable Execution(持久化执行)概念(如 Temporal 或 LangGraph 的 Checkpointer)。掌握重试机制(指数退避)、熔断降级、幂等性设计。
安全与护栏(Safety):学习提示注入(Prompt Injection)攻击原理与防御(如使用 LlamaGuard 或 NeMo Guardrails)。设计人工审核(Human-in-the-loop)的审批流。
成本与性能优化:学习模型路由(小模型处理简单任务,大模型处理复杂任务)、缓存策略(语义缓存)、流式输出优化。
实操项目:将第二阶段的旅行Agent部署上线。接入真实API,加入Trace监控,设计一套包含10个典型场景的评测集,并实现断点恢复(任务执行到一半崩溃,重启后能继续跑)。

第四阶段:前沿探索(保持“嗅觉”)
目标:跟上行业迭代,理解底层原理,形成自己的方法论。
必学内容:
核心论文精读:不用全读,重点读几篇奠基之作:ReAct(推理与行动结合)、Toolformer(模型自学用工具)、Reflexion(自我反思纠错)。理解 Agent 的底层范式。

开源模型部署:学会用 vLLM 或 Ollama 本地部署开源模型(如 Llama、Qwen)。这能让你深刻理解量化(Quantization)、显存管理,以及为什么本地部署能省成本。
框架源码阅读:挑一个核心框架(建议LangGraph),读它的源码,理解状态机是如何管理的,这比用100次API都管用。
实操项目:尝试自己用纯代码(不依赖LangChain)实现一个简单的Agent循环,包含工具注册、上下文拼接和错误处理,体会框架帮我们做了什么。

给三个核心建议:
“端到端”胜过“碎片化”:不要只学Prompt,也不要只学框架。一定要把一个项目从“能跑”做到“能上线”。只有上线后,你才会遇到真实的并发、超时、脏数据、模型幻觉,这些才是FDE真正的成长养料。
建立“评测驱动”的思维:没有评测,就没有优化。在写任何Prompt之前,先想清楚“怎么衡量对错”。这个习惯能让你在复杂系统中保持清醒。

保持“不迷信”的态度:前沿领域变化极快,今天的“最佳实践”可能下个月就过时。不要只学某个框架的API,要学它的设计思想(比如为什么需要状态管理?为什么需要持久化?)。掌握了底层逻辑,无论工具怎么变,你都能快速上手。
这条路很长,但方向很清晰。尝试用纯代码写一个带工具调用的Agent,不依赖任何高级框架,先踩一遍坑,你会发现后面的学习会顺畅很多。争取早日成为那个能“兜底”一切的FDE。

真正成为一名优秀的FDE工程师看四个维度:1、架构与任务拆解:判断问题该用单次大模型调用、工作流还是多智能体,业务怎么拆成步骤、失败怎么恢复、怎么验收。 2、工具调用与上下文工程:设计工具Schema、约束权限、处理超时异常、压缩上下文,让智能体能规划、调用、保留状态。3、测评测试与可观测性:用标准衡量输出对不对,靠Trace记录每步推理和工具调用,避免上线变黑盒。4、生产可靠性与人机协同:状态持久化、断点恢复、人工审核边界、成本延迟控制、误操作防护,以及日志监控、降级回滚等安全护栏。前两点决定能不能做出来,后两点决定做出来的系统是否真正可用、稳定、能持续迭代。

这样的框架非常重要,而且具有很高的行业共识度。它精准地抓住了大模型应用开发(即Agent/FDE方向)与传统后端开发或单纯算法调参的本质区别。
这套方法论已经把“能跑通Demo”和“能上线营运”彻底分开。我从“为什么这是核心”和“具体如何落地”两个层面,为你进一步拆解:

一、为什么前两点决定“能不能做出来”?
这两点考验的是工程师把大模型“不可控”的智力,装进“可控”的工程骨架里的能力。
维度1:架构与任务拆解——考验“逻辑抽象力”
很多新手拿到需求只会盲目调用API,但合格的FDE首先要回答“这个问题的复杂度在哪里”。
单次调用 vs 工作流 vs 多智能体:这是成本与可控性的权衡。如果查个天气都要搞三个Agent来回对话,系统必然慢且贵。专家强调“判断”,意味着FDE要能识别任务的原子性。例如,写一篇周报适合单次调用;但“市场调研→竞品分析→自动生成PPT”就要拆成工作流,每个节点有明确的输入输出。
失败恢复与验收:大模型会出错,FDE必须预设“如果这一步结果不符合预期,是重试、降级,还是抛给人工?”同时,每个节点必须有明确的验收标准(如输出JSON格式校验、关键字段是否有值),否则下游任务会收到脏数据。
维度2:工具调用与上下文工程——考验“细节掌控力”
这是Agent区别于ChatBot的核心。你要让模型学会“使用工具”,而不是只“会聊天”。
工具Schema设计:函数参数名、类型提示要写清楚,不然模型猜不透就瞎传参。这考验的是对接外部系统(如数据库、API)的规范能力。
上下文压缩:这是最考验经验的。比如连续10轮对话后,历史信息太长会把模型“淹没”,导致优先级混乱。FDE要懂得怎么把对话历史压缩成摘要,或者只保留关键实体和意图,避免超出上下文窗口或产生幻觉。

二、为什么后两点决定“是否能真正可用、稳定、能持续迭代”?
一个做出来的系统如果无法衡量、无法维护、无法兜底,在业务方眼里就是“失控的黑盒”,随时会被舍弃。
维度3:测评测试与可观测性——考验“科学度量力”
大模型不像传统代码会报明确错误,它只会“答非所问”。所以必须建立一套“度量体系”。
标准衡量输出:不能用感觉评判。要建立评测集,比如拿100条业务问询,跑一遍,对比模型回答和标准答案的相似度或通过率。持续优化Prompt和引入新数据时,跑一遍评测集看分数是否掉线。
Trace记录可观测:生产环境发生幻觉时,必须能回放“它当时看到了什么上下文?调用了哪个工具?为什么选择了这个工具?”这相当于给大模型装了“行车记录仪”,让每个决策都有迹可循,否则排错无从下手。

维度4:生产可靠性与人机协同——考验“工程底线力”
这是从“实验室”走向“生产”的生死线。
状态持久化与断点恢复:大模型任务可能跑好几分钟,要是中途网络断了就前功尽弃,这不可接受。FDE必须将任务状态存到数据库,重启后能接着跑,而不是从头再来。
人工审核边界:经费预算、法律合同、客户回复等高风险动作,系统必须有“闸门”。FDE要设计好“机器做决定,人做审核”的分工,明确哪些操作需要人工点击确认才算生效。
成本与延迟控制:模型调用是烧钱的。FDE要会做“模型路由”,简单的走小模型,复杂的走大模型;设置超时熔断,避免一个死循环耗尽Token。
护栏与降级:系统必须耐操。触发敏感词要拦截;模型服务商宕机要能切备用方案;新Prompt上线效果变差要能一键回滚。

三、给你的补充洞察(如何判断人才水平)
面试或评估FDE时,建议用场景题直接针对这几点,比如:
问:一套客服系统上线后回复不准确,但后端无报错,你怎么排查?(考察维度3的可观测性和评测集建设)。
问:业务要求多智能体协作写深度报告,但成本贵一倍,且经常因某一步出错全盘重跑,你如何优化?(考察维度1的任务拆解和维度2的上下文优化)。
问:晚上11点,模型供应商接口超时,导致用户侧排队的任务积压,你会采取什么动作?(考察维度4的降级回滚与断点恢复)。

总结:
专家们的观点,本质上是在强调“FDE是工程师,不是炼丹师”。前两点解决的是“从0到1”的构建智慧,后两点解决的是“从1到100”的运维坚韧。一个优秀的FDE,应该左手拿着“系统架构的蓝图”,右手握着“生产运维的扳手”,中间用“严谨的测评”随时校准,这样的系统才能真正承载业务价值。


